
01 Contexte
Un besoin de plateforme no-code, déployée comme un produit de production.
NocoDB est une alternative open-source à Airtable qui transforme n'importe quelle base de données en interface de type tableur (grid, kanban, galerie, formulaire…). Ce projet d'examen consiste à la déployer en conditions réelles de production chez le cloud provider Linode.
Le travail est découpé en deux dépôts complémentaires qui illustrent la séparation classique applicatif / infrastructure :
- nocodb-appli — build d'une image Docker NocoDB personnalisée (patches, analyse SonarCloud) et push vers le GitLab Container Registry, puis déclenchement automatique du pipeline d'infrastructure.
- nocodb-infra — provisionnement (Terraform) et configuration (Ansible) de l'infrastructure complète, supervision, alerting, backups et tests de charge.
02 Enjeux business
Le projet a une dimension stratégique importante pour QuickData :
| Enjeu | Description |
|---|---|
| Autonomie des équipes | Réduire la dépendance aux développeurs pour la gestion quotidienne des données |
| Standardisation | Centraliser la donnée autour d'un outil unique, connecté aux outils existants (BI, ML, reporting) |
| Souveraineté des données | Solution open source auto-hébergée garantissant confidentialité et contrôle total |
| Disponibilité et sécurité | Interface performante, hautement disponible, avec un modèle de permissions granulaire |
03 Objectifs clés
Industrialiser le déploiement et garantir un niveau de production.
- Bastion sécurisé : point d'entrée unique (jump host + VPN WireGuard + proxy Squid + NAT).
- Cluster Docker Swarm : manager + worker pour orchestrer l'application.
- Supervision : stack Prometheus + Grafana avec alerting Slack (warning / critical).
- Backups automatisés : sauvegardes quotidiennes PostgreSQL vers Linode Object Storage.
- CI/CD complet : provisioning → configuration → déploiement → tests → initialisation des clients.
- Multi-tenant : création automatisée des clients NocoDB (projets, bases, utilisateurs).
04 Stack technique
Une chaîne d'outils 100 % Infrastructure as Code et GitOps-friendly.
Infrastructure as Code
Terraform (providers Linode + OVH) pour le provisioning, Ansible (12 rôles) pour la configuration des VMs.
Conteneurs & Orchestration
Docker + Docker Swarm, image NocoDB personnalisée buildée depuis les sources GitHub.
CI/CD & Qualité
GitLab CI (pipelines chaînés), SonarCloud, GitLab Container Registry, stratégie de tags par SHA et par branche.
Supervision
Prometheus (v3.12), Grafana (v13), node_exporter, dashboards provisioning, alertes Slack.
Réseau & Sécurité
VPC privé 10.0.1.0/24, WireGuard VPN, Fail2ban, Squid, firewalls inbound DROP, Traefik + Let's Encrypt.
Tests & Données
Locust (tests de charge), PostgreSQL 16, Linode Object Storage (S3) pour les backups et artefacts.
05 Architecture
4 VMs Linode interconnectées via un VPC privé, derrière un bastion unique.
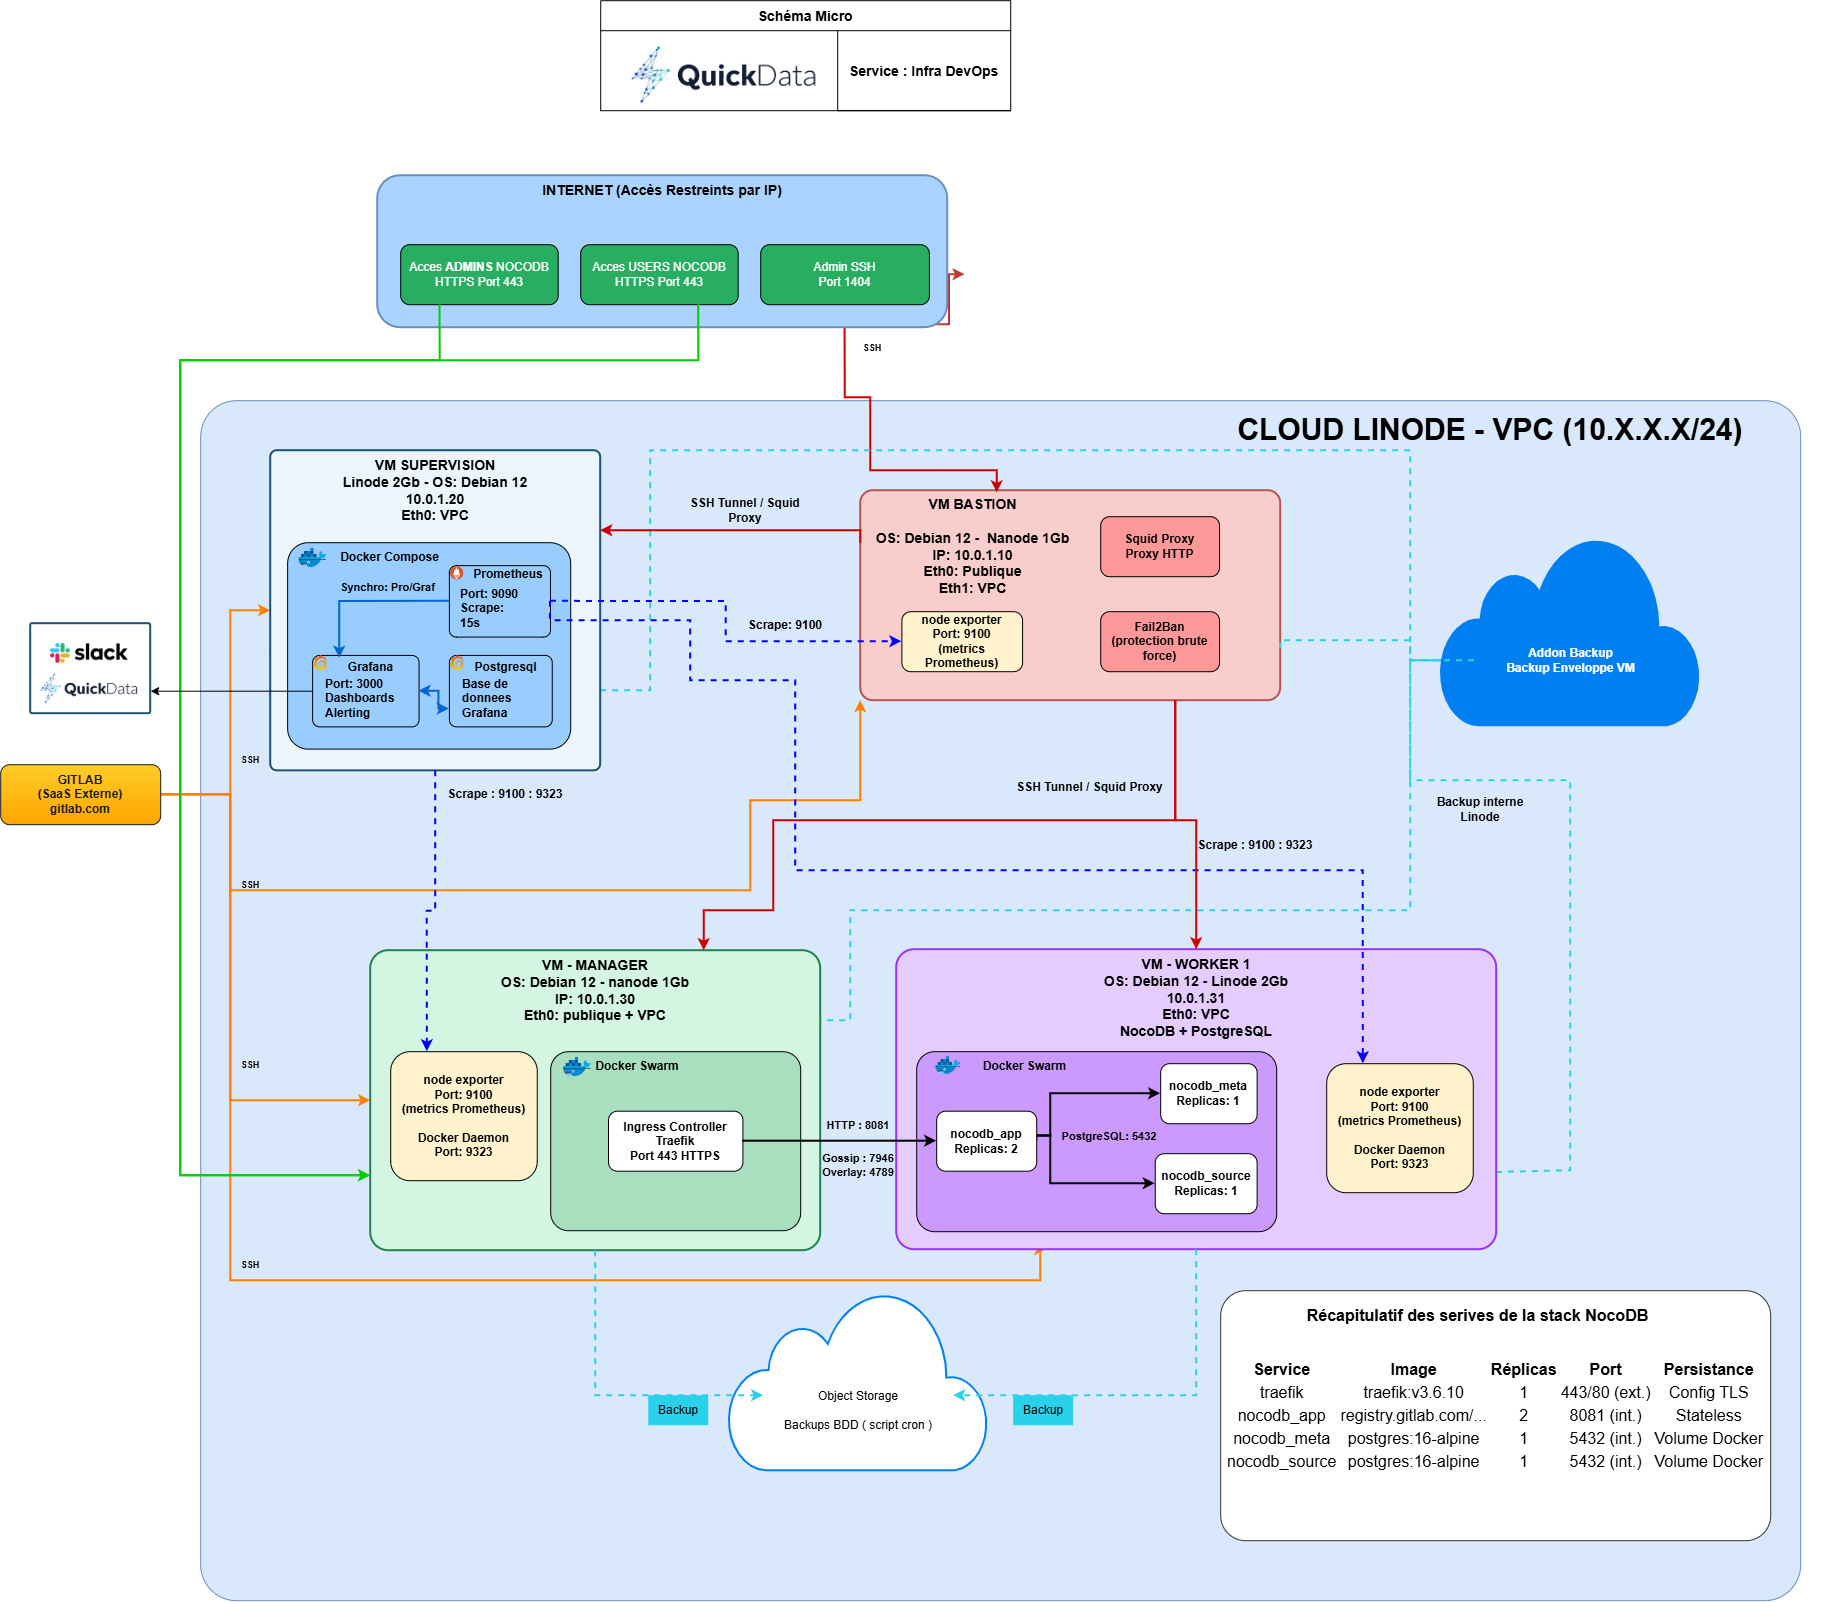
| Rôle | IP VPC | IP publique | Type Linode | Fonction |
|---|---|---|---|---|
| Bastion | 10.0.1.10 | Oui | g6-nanode-1 | SSH, proxy, NAT, VPN, DNS |
| Supervision | 10.0.1.20 | Non | g6-standard-1 | Prometheus + Grafana + PostgreSQL |
| Manager | 10.0.1.30 | Oui | g6-nanode-1 | Orchestrateur Swarm + Traefik HTTPS |
| Worker1 | 10.0.1.31 | Non | g6-standard-1 | Bases PostgreSQL + application NocoDB |
Tout accès SSH passe obligatoirement par le bastion (principe du ProxyJump) : le port SSH standard (22) est fermé depuis l'extérieur et seul le bastion répond sur le port 1404. Les firewalls sont en inbound DROP par défaut et n'ouvrent que le strict nécessaire — SSH (1404) et WireGuard (51820) sur le bastion, HTTPS (443) sur le manager — le reste ne circulant qu'au sein du VPC privé 10.0.1.0/24.
Le VPC est provisionné en Terraform, avec un sous-réseau unique 10.0.1.0/24 dont les adresses sont attribuées manuellement pour la cohérence de l'architecture :
# terraform/vpc.tf — réseau privé isolé par environnement (dev/prod)
resource "linode_vpc" "vpc1" {
  label       = "${var.env}-vpc-${var.client}"
  region      = var.region
  description = "Réseau privé isolé pour les VMs internes"
}

resource "linode_vpc_subnet" "subnet1" {
  vpc_id = linode_vpc.vpc1.id
  label  = "${var.env}-subnet-${var.client}"
  ipv4   = "10.0.1.0/24"   # .10 bastion · .20 supervision · .30 manager · .31 worker1
}
06 CI/CD & Déploiement
Deux pipelines GitLab chaînés : l'image d'abord, l'infrastructure ensuite.
Pipeline applicatif (nocodb-appli) — 4 stages
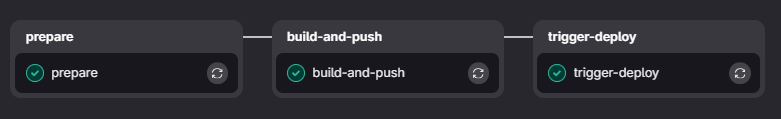
| Stage | Jobs | Rôle |
|---|---|---|
| prepare | clone + patches | Clonage du dépôt et application des patches |
| analyze | SonarCloud | Analyse qualité du code (merge requests + branche dev) |
| build-and-push | Docker build + push image | Construction et publication de l'image Docker |
| trigger-deploy | trigger API (nocodb-infra) | Déclenchement du pipeline infrastructure |
- Stratégie de tags : chaque build produit 3 tags — par SHA (immutable, rollback), par branche (
:dev/:main), et:custom(compatibilité). - L'analyse qualité SonarCloud est déclenchée sur les merge requests et la branche
dev. - Le stage trigger-deploy déclenche le pipeline d'infrastructure via l'API REST de GitLab avec un
Pipeline Trigger Tokendédié (variable protégéeINFRA_TRIGGER_TOKEN), pour un contrôle plus fin des conditions de déclenchement et de la branche ciblée.
Pipeline infrastructure (nocodb-infra) — 20 jobs, 7 stages
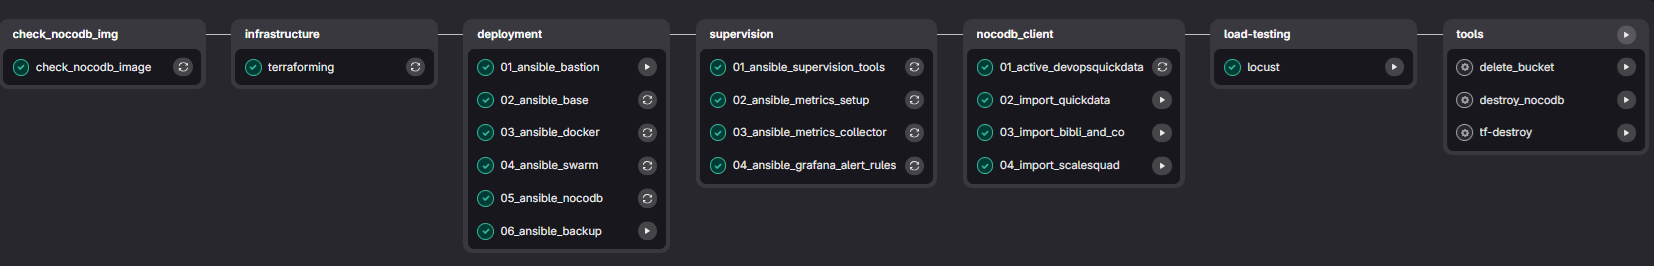
| Stage | Jobs | Rôle |
|---|---|---|
| check | check_nocodb_image | Vérifie la présence de l'image NocoDB custom |
| infrastructure | terraforming | Terraform apply + inventaire Ansible + artefacts S3 |
| deployment | bastion → base → docker → swarm → nocodb → backup | Configuration séquentielle des VMs via Ansible |
| supervision | supervision_tools → metrics_setup → metrics_collector → alert_rules | Stack Prometheus/Grafana + alerting |
| nocodb_client | import_* (manuels) | Création des projets clients NocoDB |
| load-testing | locust | Test de charge 100 utilisateurs, rapport HTML |
| tools | destroy_nocodb / delete_bucket / tf-destroy | Destruction contrôlée (manuel) |
Le flux complet : push sur dev/main → build image → trigger infra → provisioning Terraform → configuration Ansible → application accessible en HTTPS via Traefik.
Quelques choix de conception notables : une vérification préalable (check_nocodb_image) s'assure que l'image attendue existe dans le registry avant tout provisionnement (les VMs Linode étant facturées à l'usage) ; les chaînes Ansible deployment et supervision s'exécutent en parallèle pour réduire la durée totale du pipeline ; et les actions sensibles ou coûteuses (tests de charge, destruction, imports clients) restent manuelles.
Fichiers sources
L'intégralité du pipeline est versionnée dans le dépôt : consultez le .gitlab-ci.yml (20 jobs, 7 stages) et le playbook Ansible principal qui orchestre les 12 rôles via ses tags.
Structure du dépôt nocodb-infra
Le code d'infrastructure est organisé autour de trois blocs — Terraform (provisioning), Ansible (configuration, 12 rôles) et GitLab CI (orchestration) :
nocodb-infra/
├── .gitlab-ci.yml            # pipeline (20 jobs, 7 stages)
├── .ci/                      # helpers du runner (ansible, terraform)
├── terraform/                # provisioning Linode
│   ├── providers.tf          #   linode + ovh + backend HTTP
│   ├── vpc.tf                #   VPC 10.0.1.0/24
│   ├── vm-bastion.tf         #   bastion + firewall DROP
│   ├── vm-nocodb-manager.tf  #   manager Swarm
│   ├── vm-nocodb-worker1.tf  #   worker Swarm
│   └── vm-supervision.tf     #   VM supervision (VPC-only)
├── ansible/
│   ├── site.yml              # playbook principal (12 rôles, tags ↔ jobs CI)
│   ├── group_vars/           # variables par groupe (all, supervision)
│   └── roles/
│       ├── bastion/          # fail2ban · squid · wireguard · NAT
│       ├── base/             # proxy + dépendances + scripts stress-test
│       ├── docker_install/   # Docker Engine
│       ├── swarm_init/       # init Swarm (manager)
│       ├── swarm_join/       # join des workers
│       ├── gitlab_login/     # pull des images depuis le registry
│       ├── nocodb/           # stack applicative NocoDB
│       ├── backup/           # pg_dump → S3 (systemd timer)
│       ├── supervision_tools/# docker-compose PG/Prometheus/Grafana
│       ├── metrics_setup/    # node_exporter (toutes les VMs)
│       ├── metrics_collector/# prometheus.yml (génération dynamique)
│       ├── grafana_alert_rules/# contact-points + alert rules
│       └── nocodb_clients/   # import des données clients
└── locust/                   # tests de charge (100 utilisateurs)
Lien jobs GitLab CI ↔ rôles Ansible
Chaque job du pipeline cible un tag du playbook site.yml, garantissant une correspondance stricte entre l'orchestration CI et la configuration :
# ansible/site.yml — extrait
- name: Déploiement de la stack supervision (Prometheus + Grafana + Postgres)
  hosts: supervision
  become: true
  tags: [monitoring, supervision, supervision_tools]
  roles: [supervision_tools]

- name: Installation des agents collector sur toutes les machines
  hosts: all
  become: true
  tags: [monitoring, supervision, metrics_setup]
  roles: [metrics_setup]
07 Supervision & Alerting
Une stack de monitoring déployée en 4 étapes sur la VM supervision.
- Services : PostgreSQL 16 (backend Grafana), Prometheus v3.12.0 (scrape toutes les 15s), Grafana v13.0.1 — images versionnées, healthchecks actifs, volumes persistants.
- Agents : node_exporter installé sur toutes les VMs (CPU, RAM, disque, réseau), métriques du daemon Docker Swarm (port 9323).
- Dashboards : provisionnés automatiquement (MCO & Perf, Node Exporter Full, Node Exporter Server).
La stack est déployée via docker-compose (3 services interconnectés), avec des healthchecks et des volumes persistants :
# ansible/roles/supervision_tools/templates/docker-compose.yml.j2
services:
  postgres:
    image: postgres:{{ graf_postgres_image_version }}
    volumes: [pgsql-data:/var/lib/postgresql/data]
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U {{ graf_postgres_user }} -d {{ graf_postgres_db }}"]
    restart: unless-stopped

  prometheus:
    image: prom/prometheus:{{ prometheus_image_version }}
    volumes:
      - "{{ prometheus_config_path }}/{{ prometheus_config_file }}:/etc/prometheus/prometheus.yml"
      - "{{ prometheus_data_path }}:/prometheus"
    restart: unless-stopped

  grafana:
    image: grafana/grafana:{{ grafana_image_version }}
    environment:
      GF_DATABASE_TYPE: postgres
      GF_DATABASE_HOST: postgres:5432
    depends_on:
      postgres:   { condition: service_healthy }
      prometheus: { condition: service_healthy }
    restart: unless-stopped
Dashboards Grafana provisionnés automatiquement
Les dashboards sont déployés via le provisioning automatique de Grafana (hot-reload, sans intervention manuelle), ce qui garantit un rendu identique sur chaque environnement (dev / prod) et une mise en place reproductible dès le deploy.
Le provider de dashboards est déclaré en YAML (template Jinja2) : chaque dossier du dépôt est mappé vers un dossier Grafana dédié, avec un rechargement toutes les 30 secondes :
# ansible/roles/supervision_tools/templates/grafana/provisioning/dashboards/dashboards.yml.j2
apiVersion: 1

providers:
  - name: "MCO-Perf"
    type: file
    updateIntervalSeconds: 30
    allowUiUpdates: true
    options:
      path: /etc/grafana/provisioning/dashboards/mco-perf
    folder: "MCO & Perf"

  - name: "MCO-Container"
    type: file
    updateIntervalSeconds: 30
    allowUiUpdates: true
    options:
      path: /etc/grafana/provisioning/dashboards/mco-container
    folder: "MCO & Container"

  - name: "Template-Base"
    type: file
    updateIntervalSeconds: 30
    allowUiUpdates: true
    options:
      path: /etc/grafana/provisioning/dashboards/template-base
    folder: "Template-Base"
Les dashboards au format JSON sont versionnés dans le dépôt puis déployés par Ansible en préservant l'arborescence :
ansible/roles/metrics_collector/files/grafana/provisioning/dashboards/
├── mco-container/
│   └── mco-container.json               # Dashboard « Docker Swarm – NocoDB »
├── mco-perf/
│   └── mco-perf-node-metrics.json       # Dashboard « MCO & Perf – Node Metrics »
└── template-base/
    ├── 1860-node_exporter_full.json     # Dashboard communautaire « Node Exporter Full »
    └── 21476_rev2.json                  # Dashboard communautaire « Node Exporter Server »
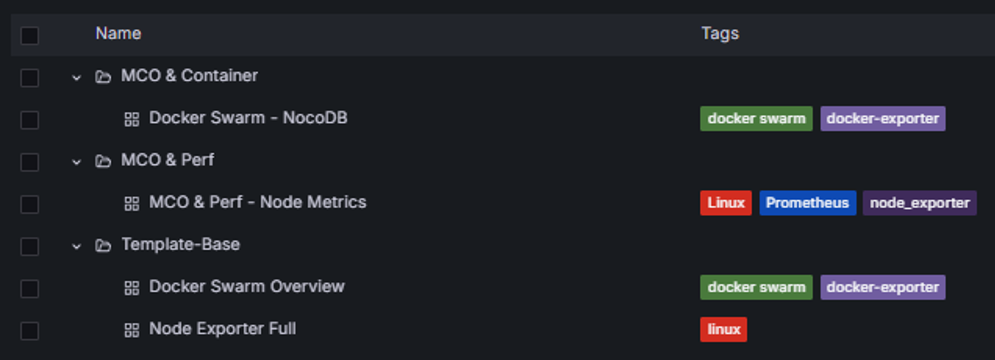
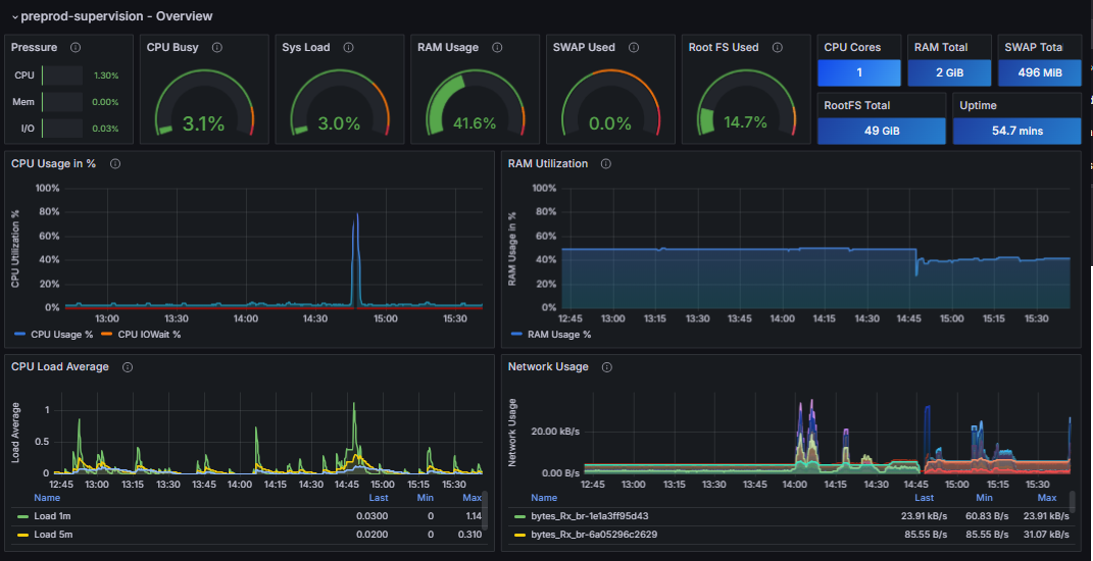
Les dashboards sont répartis en deux dossiers : « MCO & Perf » (métriques système de chaque VM) et « Docker Swarm – NocoDB » (état des containers applicatifs). À côté du dashboard personnalisé MCO & Perf – Node Metrics, deux dashboards communautaires de référence (Node Exporter Full, Node Exporter Server) complètent la vue.
Pour entrer dans le détail, le dashboard personnalisé « MCO & Perf – Node Metrics » agrège les métriques système remontées par chaque node_exporter et les restitue en panneaux CPU, RAM, disque, réseau et disponibilité :
La configuration Prometheus est générée dynamiquement par Ansible : une boucle Jinja ajoute automatiquement chaque VM du groupe all comme cible node_exporter, sans édition manuelle.
# ansible/roles/metrics_collector/templates/prometheus.yml.j2
scrape_configs:
  - job_name: "node_exporter"
    static_configs:
{% for host in groups['all'] %}
      - targets:
          - "{{ hostvars[host]['ansible_private_ip'] }}:{{ node_exporter_port }}"
        labels:
          hostname: "{{ host }}"
{% endfor %}
Fichiers sources — rôles de la stack supervision
Chaque étape de la stack correspond à un rôle Ansible dédié dont voici le tasks/main.yml : déploiement des services (supervision_tools), installation des agents node_exporter (metrics_setup) et collecte des métriques (metrics_collector).
Alerting
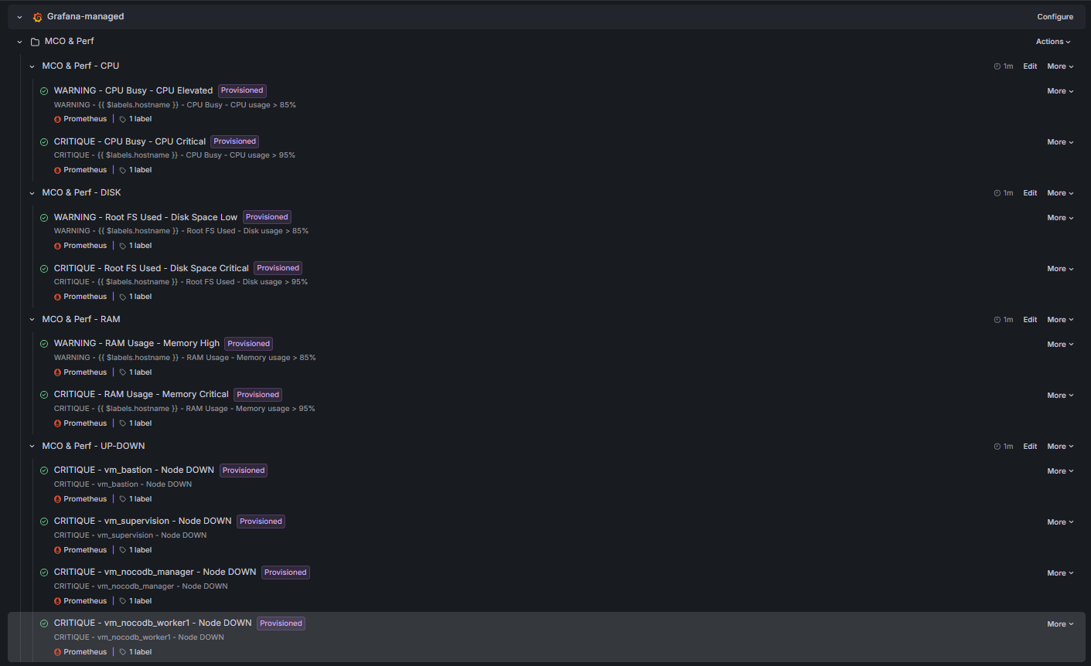
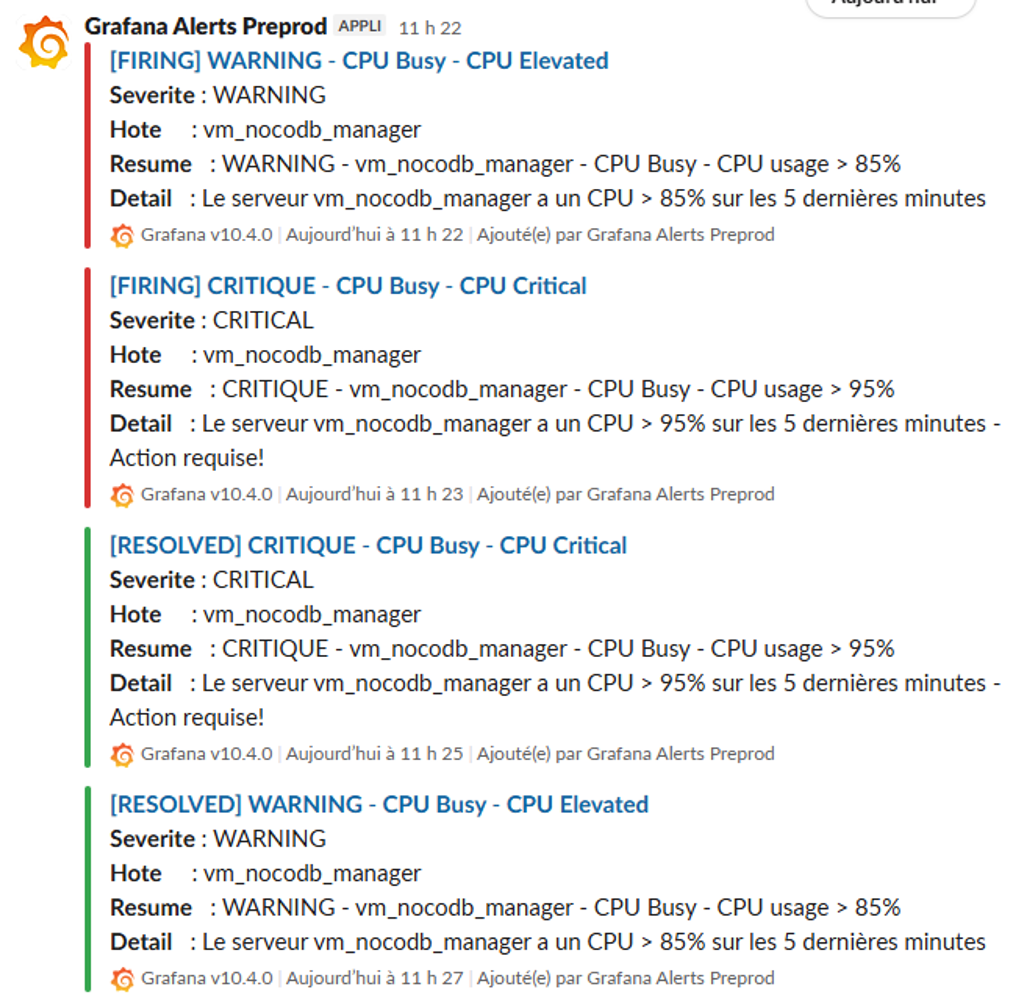
Deux niveaux de sévérité (warning / critical) avec une persistance de 5 minutes, afin de filtrer les pics ponctuels et de n'alerter que sur des anomalies durables. Le SMTP OVH étant bloqué par Linode, les alertes sont notifiées via un webhook Slack relié au channel de l'équipe, avec un webhook sélectionné automatiquement selon l'environnement (prod / preprod).
Fichiers sources
La règle UP/DOWN (lignes « Hosts DOWN » et « Node DOWN » du tableau ci-dessous) est générée dynamiquement par Ansible : une boucle Jinja crée une alerte « Node DOWN » par VM à partir de ce template.
Seuils d'alerte
| Métrique | Seuil warning | Seuil critique | Condition |
|---|---|---|---|
| CPU Busy | > 85 % | > 95 % | 5 min |
| RAM Usage | > 85 % | > 95 % | 5 min |
| Disque / | > 85 % | > 95 % | 5 min |
| Hosts DOWN | — | injoignable | 1 min |
| Node DOWN | — | injoignable | 2 min |
Les seuils à 85 % / 95 % laissent une marge suffisante pour agir avant la bascule en critique, et la persistance de 5 minutes filtre les pics ponctuels (batch, montée de charge courte) pour n'alerter que sur des anomalies durables. Les règles UP/DOWN n'ont pas de seuil intermédiaire — un hôte est up ou down — avec une persistance réduite car l'indisponibilité totale doit être remontée rapidement. La règle Node DOWN (nœuds Swarm) n'est pas encore activée : elle est prévue pour une prochaine itération.
Notification Slack
Chaque métrique est organisée en rule group dédié (MCO & Perf – CPU / DISK / RAM / UP-DOWN), provisionné et évalué sur un intervalle d'une minute. La chaîne a été validée de bout en bout à l'aide de scripts de stress test déployés sur chaque VM (stress-test-cpu.sh, stress-test-ram.sh) : ils montent artificiellement le CPU/RAM pour déclencher les alertes Warning/Critical et vérifier la notification Slack puis la résolution automatique.
Le routage des notifications est lui aussi provisionné en YAML, avec une politique dédiée par sévérité :
# ansible/roles/grafana_alert_rules/templates/notification-policies.yml.j2
policies:
  - receiver: "{{ grafana_alert_contact_point_name }}"   # webhook Slack
    group_by: [alertname, nodename, severity]
    routes:
      - matchers: [severity = warning]
        group_interval: 5m
        repeat_interval: 4h
      - matchers: [severity = critical]
        group_interval: 1m
        repeat_interval: 1h
Fichiers sources — rôle grafana_alert_rules
Le rôle Ansible grafana_alert_rules provisionne l'ensemble de l'alerting : contact point Slack, politiques de notification et règles d'alerte JSON (CPU, RAM, disque). Voici les fichiers tels qu'ils sont versionnés dans le dépôt.
Provisioning & notification
Règles d'alerte (seuils CPU / RAM / Disque)
08 Backups
Sauvegardes quotidiennes automatisées vers Linode Object Storage.
- Fréquence : quotidienne, via un
systemd timer. - Rétention : 7 jours (configurable).
- Technologie :
pg_dump→ uploads3cmdvers le bucket S3 (région fr-par-1). - Scripts :
backup.sh(dump → upload → nettoyage) etrestore.sh(restauration manuelle).
Fichiers sources
Le rôle Ansible backup orchestre l'ensemble : installation de s3cmd, déploiement des scripts backup.sh / restore.sh, puis planification automatique via le timer systemd (3 exécutions par jour).
09 Tests de charge
Validation de la tenue en charge avec Locust, intégré au pipeline.
- Scénarios : accueil (⭐⭐⭐), health check (seuil 3s), liste des projets (sollicite la DB), route 404 (résilience), fichier statique.
- Protocole : 100 utilisateurs, spawn-rate 20, durée 2 minutes, rapport HTML stylisé (Tailwind) prêt pour le jury.
- Validation :
catch_response=True— les erreurs 5xx et les lenteurs remontent dans les métriques.
| Métrique | Cible |
|---|---|
| Succès | ≥ 99 % |
| P50 (médiane) | ≤ 500 ms |
| P95 | ≤ 1000 ms |
| P99 | ≤ 2000 ms |
Fichiers sources
Le scénario de test de charge est défini dans locustfile.py : chaque tâche cible une route avec un poids et une validation catch_response pour faire remonter les erreurs 5xx et les lenteurs dans les métriques.
10 Sécurité
Une posture de production : moindre exposition, accès strictement maîtrisés.
- SSH : authentification par clé uniquement (
PasswordAuthentication no), port personnalisé sur le bastion. - Bastion : Fail2ban (3 tentatives → bannissement 24h), unique point d'entrée.
- Réseau : VPC privé 10.0.1.0/24, firewalls Linode
inbound DROPpar défaut. - VPN : tunnel WireGuard pour l'accès direct au VPC des développeurs.
- Secrets : nettoyage du fichier de stack contenant les mots de passe après déploiement.
Fichiers sources — rôle bastion
Toute la posture de sécurité est codifiée dans le rôle Ansible bastion : Fail2ban, WireGuard, NAT iptables, proxy Squid et routage, chacun dans un fichier de tâches dédié, orchestrés par le tasks/main.yml.
11 Retours d'expérience
Ce que ce projet m'a appris.
- Concevoir une architecture réseau segmentée (bastion + VPC-only) et comprendre l'enjeu du routage et du proxy pour les machines sans accès Internet.
- Industrialiser un déploiement complet avec Terraform et Ansible, de la VM nue jusqu'à l'application supervisée.
- Chaîner deux pipelines GitLab (appli → infra) avec des tags d'images immuables pour un rollback fiable.
- Mettre en place une supervision et un alerting de production (Prometheus, Grafana, Slack), en évitant les faux positifs (seuils RAM).